Un benchmark le da a un equipo de IA algo concreto para mejorar. Las respuestas reciben un puntaje, el modelo cambia y el número se mueve. Esa disciplina es valiosa. Sin ella, el equipo termina juzgando el sistema a partir de unas pocas demostraciones prolijas.
El problema aparece cuando el benchmark reemplaza al trabajo que debía mejorar.
Pensemos en una herramienta que extrae afirmaciones de informes. Una evaluación offline puede indicar si el texto extraído coincide con un conjunto de referencia, si la cita apunta al párrafo correcto y cuántas afirmaciones importantes se pierden. Son medidas significativas del modelo. No muestran qué hace el analista a continuación.
Si cada afirmación todavía debe verificarse contra el documento original, el ahorro aparente puede desaparecer. Si una corrección exige varios clics y un segundo sistema, los errores pequeños se vuelven caros. Si la salida llega a quien toma la decisión sin mostrar qué afirmaciones eran inciertas, un promedio alto puede ocultar una falla importante.
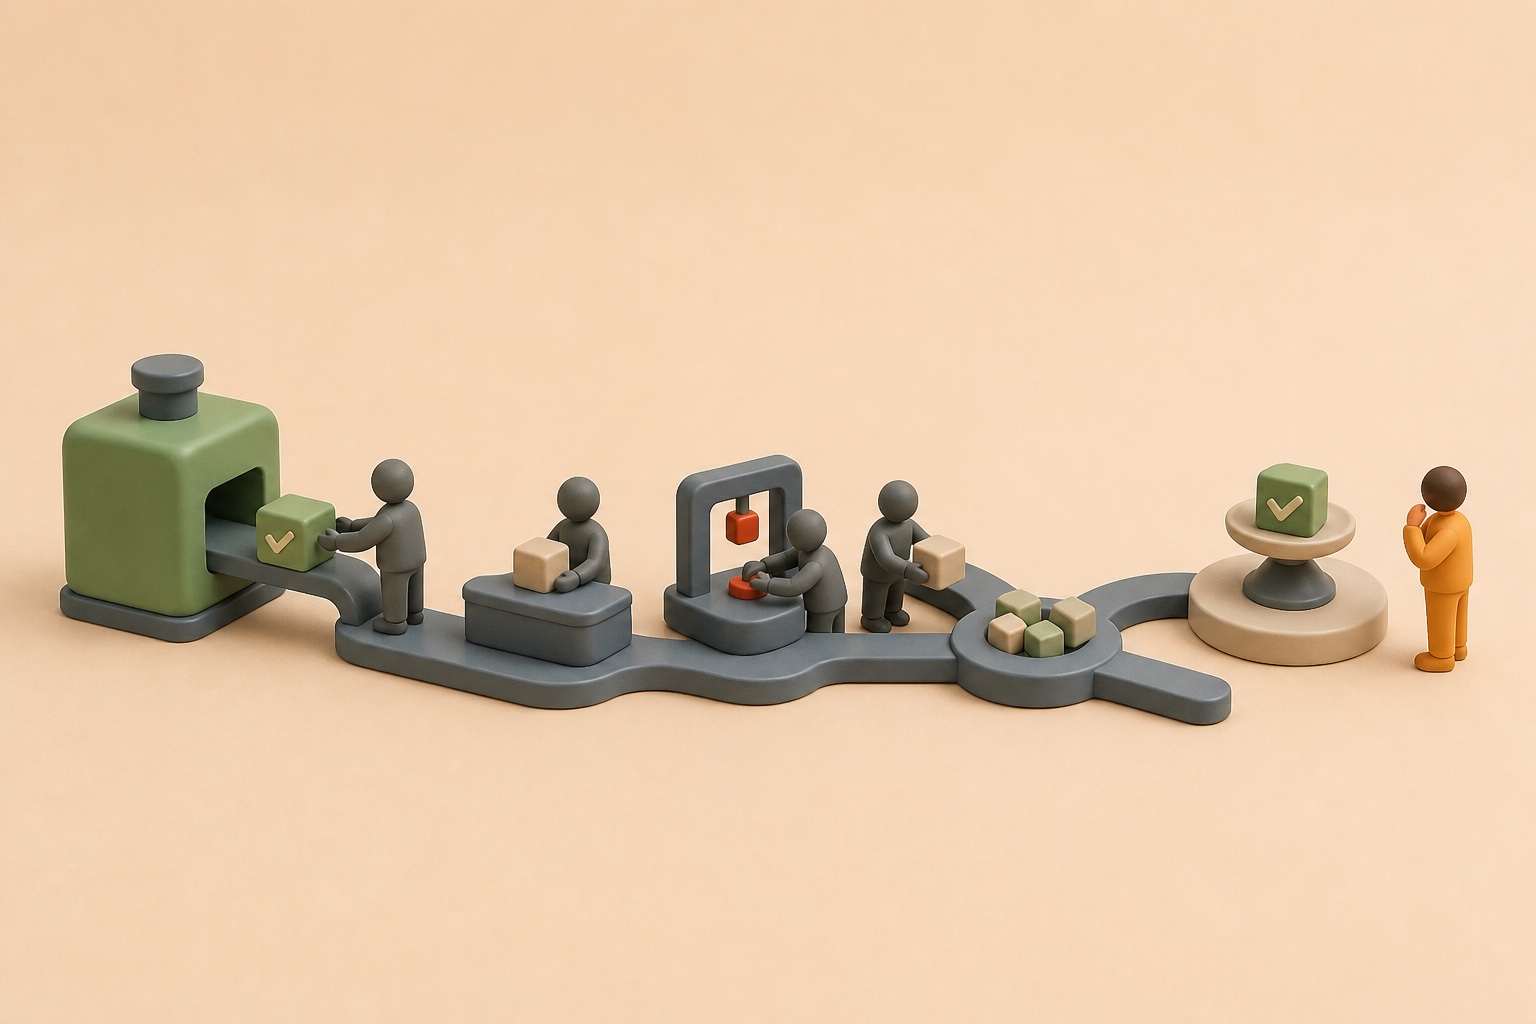
La respuesta es un producto intermedio. Su valor depende de la decisión, el traspaso o la acción que viene después.
La idea parece evidente, pero cambia el diseño de la evaluación. Además de preguntar si el modelo produjo la salida esperada, el equipo necesita saber si redujo trabajo. ¿El analista terminó antes la revisión? ¿Hubo menos casos reabiertos? ¿La siguiente persona recibió suficiente contexto para actuar? Cuando algo salió mal, ¿fue posible identificarlo y corregirlo sin reconstruir el caso completo?
Estas preguntas no reemplazan precisión, exhaustividad, latencia ni costo. Un modelo que no puede realizar su tarea central no se vuelve útil gracias a una interfaz mejor. La evaluación offline sigue siendo la vía más rápida para detectar regresiones y comparar cambios en condiciones controladas. Es el laboratorio. El error consiste en creer que el desempeño del laboratorio describe toda la operación.
Producción introduce efectos que un conjunto de datos estático pocas veces captura. Los usuarios adaptan su conducta. Revisan en exceso un sistema en el que no confían y revisan demasiado poco uno que parece seguro. Los casos llegan sin todo el contexto. Las políticas cambian. La salida entra en colas con plazos y prioridades en competencia. Una respuesta correcta que llega tarde, a la persona equivocada o sin la evidencia necesaria para aprobarla tiene poco valor práctico.
Por eso un plan de evaluación útil sigue un caso representativo más allá de la llamada al modelo. Registra la entrada, la respuesta, la revisión, cualquier corrección y el resultado final. Ese recorrido vuelve visible el trabajo oculto. También muestra dónde corresponde mejorar. A veces el cuello de botella es el modelo. Otras veces es el enrutamiento, los permisos o una pantalla de revisión que obliga a buscar contexto en otro lugar.
Las medidas deben mantenerse cerca del trabajo. En soporte pueden incluir tiempo hasta la resolución, casos reabiertos, escalamientos innecesarios y correcciones posteriores al envío de un mensaje. En operaciones documentales pueden incluir tiempo de revisión, antigüedad de las excepciones, correcciones repetidas y pagos detenidos antes de liberarse. No se trata de construir un tablero universal, sino de definir el éxito en términos reconocibles para el equipo operativo.
Hay otro beneficio: las medidas posteriores desalientan mejoras que solo trasladan el esfuerzo. Un modelo nuevo puede extraer más campos automáticamente y enviar el doble de casos ambiguos a revisión. Un resumen puede ser más corto y obligar a abrir la fuente con mayor frecuencia. Una respuesta más rápida puede crear más trabajo de seguimiento. Las métricas de salida presentan cada cambio como progreso. Las del flujo muestran la cuenta completa.
Este enfoque exige paciencia. Los puntajes del modelo aparecen antes de que existan suficientes casos de producción para evaluar resultados, y los equipos necesitan retroalimentación rápida. La salida es trabajar por capas. Ejecutar evaluaciones offline ante cada cambio relevante, probar el flujo completo con casos realistas antes de publicar y seguir un conjunto pequeño de resultados operativos después del lanzamiento.
Cuando las capas no coinciden, la diferencia es información útil. Un benchmark más alto acompañado por un mayor tiempo de revisión no invalida la evaluación. Muestra que el equipo optimizó el límite equivocado. La investigación puede concentrarse en el traspaso entre la respuesta y el trabajo.
El mejor benchmark no tiene por qué ser un solo número. Puede ser una cadena de evidencia que conecta el comportamiento del modelo con un resultado que a alguien realmente le importa.
Una respuesta solo es útil cuando mejora el trabajo que viene después.