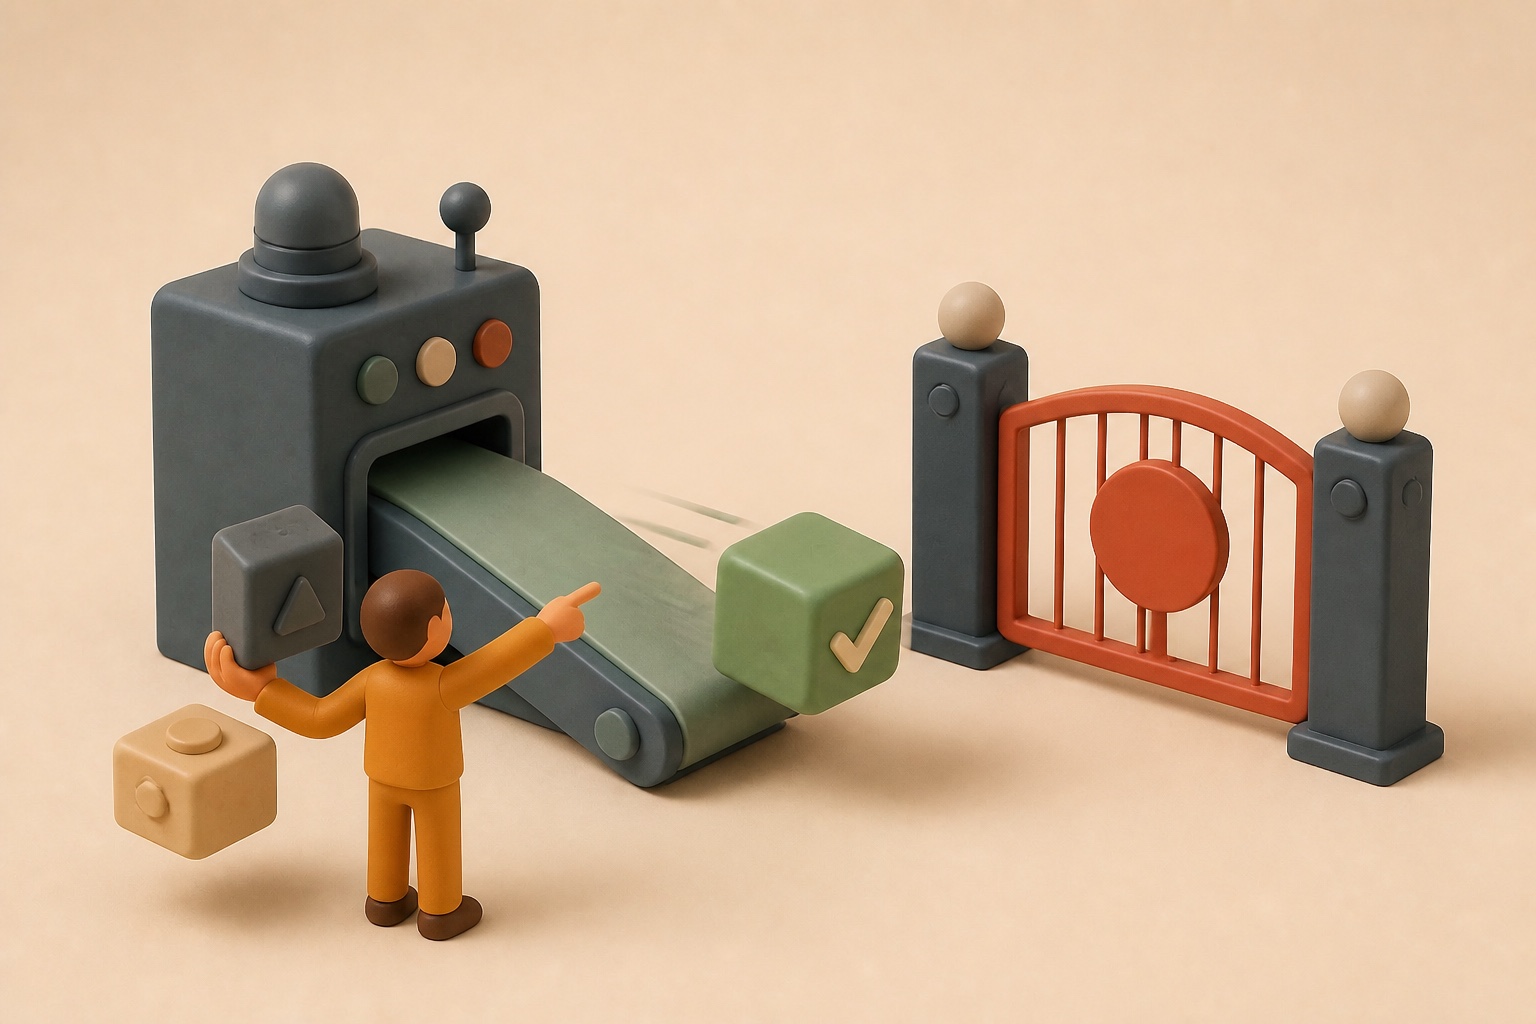
Un modelo puede dar la respuesta correcta y, aun así, provocar la acción equivocada.
La frase solo parece contradictoria si confundimos la respuesta con el sistema completo. En la práctica, cada salida de IA vive dentro de un flujo con reglas propias. Algunas fuentes tienen más autoridad que otras, ciertas acciones requieren permisos y no todos los errores cuestan lo mismo. El modelo ve un problema de predicción. La empresa enfrenta una decisión.
Pensemos en un proceso documental que reúne un contrato, una factura y un remito. Los tres pueden incluir una cantidad. Si los números no coinciden, el modelo puede elegir el valor que aparece con mayor claridad o más veces. También puede citar la página y asignar una confianza alta. Nada de eso explica cuál de los documentos debe gobernar el pago.
La respuesta puede estar bien sustentada en el texto. Pagar en función de ella todavía puede ser un error.
Esta diferencia suele perderse porque la evaluación del modelo empieza y termina en la salida. Preguntamos si el campo extraído coincide con la etiqueta, si el resumen contiene los datos importantes o si la respuesta está respaldada por la fuente. Son controles necesarios, pero no alcanzan a cubrir la decisión que el software está por tomar.
La capa que falta suele ser la autoridad. El contrato puede fijar la cantidad acordada, mientras el remito registra lo que realmente llegó. Una orden de compra corregida quizá reemplace a ambos. Qué documento prevalece depende del flujo de trabajo, no de la seguridad con la que el modelo lea la página. Si las fuentes se contradicen, el sistema necesita una política para esa contradicción. Un prompt no debería inventarla.
Los permisos presentan el mismo problema desde otro ángulo. Un asistente de soporte puede determinar correctamente que corresponde un reintegro. Eso no significa que deba emitirlo. El monto, el historial de la cuenta, el medio de pago o una exigencia regulatoria pueden requerir la aprobación de una persona. Clasificar y autorizar son trabajos distintos, aunque la interfaz los muestre como un solo paso.
También importan las consecuencias. Una etiqueta interna mal asignada se corrige en segundos. Un mensaje enviado a un cliente, un pago liberado o dos registros unidos en la cuenta equivocada no. Aplicar el mismo umbral de confianza a todas esas acciones confunde certeza estadística con seguridad operativa.
Por eso un modelo mejor no produce automáticamente un sistema mejor. Más precisión puede reducir una clase de error y dejar intacta la decisión que lo rodea. Incluso puede volver más riesgoso un flujo débil: las personas dejan de revisar porque las respuestas parecen plausibles de manera consistente.
La salida práctica es diseñar primero la decisión. Hay que identificar las fuentes y declarar cuál tiene autoridad. También conviene definir qué debe ocurrir cuando no coinciden, separar las recomendaciones de las acciones y restringir los permisos para los pasos de mayor impacto. La evidencia debe permanecer adjunta para que una persona pueda entender por qué el sistema llegó a su conclusión.
Ese trabajo luce menos que una demostración del modelo, pero ahí se construye la confianza. Los usuarios no necesitan que un sistema de IA sea vagamente inteligente. Necesitan que se comporte de forma previsible cuando faltan datos, las reglas chocan o aumenta el costo de equivocarse.
Una revisión útil puede empezar con preguntas bastante comunes. ¿Qué hecho intenta establecer el modelo? ¿Qué fuente está autorizada para establecerlo? ¿Quién puede actuar sobre esa conclusión? ¿La acción se puede revertir? ¿Qué hace el sistema cuando la confianza es alta, pero las fuentes se contradicen?
Si esas preguntas no tienen respuesta, otra ronda de ajustes al prompt no va a cerrar la brecha. Quizá mejore la presentación, mientras la ambigüedad de fondo permanece exactamente en el mismo lugar.
El modelo es un componente. El producto también incluye políticas, permisos, escalamiento y recuperación. Tratar esas decisiones como detalles de implementación es la forma más directa de convertir una respuesta plausible en un error operativo.
La respuesta puede ser correcta y el sistema, aun así, estar equivocado.